React·TypeScript와 NestJS·TypeORM·MySQL로 회원·게시글·댓글을 연결한 웹 서비스입니다. 강의용 프로젝트를 기반으로 작성자·관리자 권한을 구현하고, 후속 확장에서는 글별 비밀번호를 사용하는 비공개 게시글과 JWT 키 관리, 관리자 활동 리포트를 추가했습니다. SQL에서는 JOIN·CTE·윈도우 함수를 적용하고 실제 MySQL에서 중복 집계와 기간 경계를 검증했습니다.
본인 기여화면·API·DB 연결과 JWT 인증·CRUD·권한 처리를 구현했습니다. 후속 작업으로 비공개 글의 작성자·비밀번호 이중 확인, 서명 키 생성·교체·폐기, 회원별 활동 집계와 회귀검사를 확장했습니다. 교육 과정의 AWS EC2·Jenkins 배포와 Prometheus·Grafana 모니터링 경험은 운영 구성 문서에 정리했습니다.
01 / 문제
로그인 여부만 확인하면 글 ID를 바꿔 타인의 데이터에 접근할 수 있습니다. 게시글과 댓글을 직접 JOIN하면 활동 수가 중복 집계될 수 있습니다.
02 / 설계
서버의 작성자 검사와 글 비밀번호 확인을 함께 적용하고 RS256 키 교체 절차를 만들었습니다. 두 활동 테이블은 회원별 CTE 집계 후 JOIN했습니다.
03 / 검증
MySQL 8 HTTP 통합 테스트 30개로 ID 우회·토큰 변조와 집계·기간 경계를 확인했습니다. 같은 검사와 양쪽 빌드를 GitHub Actions에 구성했습니다.
로그인·요청React → RS256 JWT
→
서버 권한 검사회원 ID = 작성자 ID
→
비공개 글 확인bcrypt → 5분 확인 토큰
→
접근·저장NestJS → TypeORM · MySQL
담당 구현 · 권한 경계와 데이터 정확성
01 / API · DB회원·게시글·댓글 관계
회원가입 정보를 MySQL에 저장하고, NestJS Controller·Service와 TypeORM 엔티티로 요청·업무 처리·저장을 나눴습니다. 게시글 CRUD와 댓글 등록·조회·삭제, 목록 페이지 조회를 연결했습니다. 공개 응답의 작성자는 ID·이름만 제공하며 비밀번호 해시는 제외합니다.
users 1:N posts · posts 1:N comments · users 1:N comments
02 / 비공개 글ID 변경과 댓글 경유 접근 차단
JWT로 확인한 회원과 DB 작성자가 일치해야 글별 비밀번호를 bcrypt 해시와 비교합니다. 다른 회원은 비밀번호를 알아도 접근할 수 없고 관리자에게도 타인의 비공개 본문 열람 예외를 주지 않습니다. 열람·수정·삭제·댓글 요청마다 같은 경계를 검사합니다.
작성자 확인 → 글 비밀번호 검증 → 회원·글·버전 한정 토큰(5분) · 브라우저 메모리 보관
03 / JWT 키기본 공유 키 제거와 교체·폐기
기본 dev-secret 대신 RSA 3072비트·RS256을 사용하고 키가 없거나 잘못되면 서버 시작을 거부합니다. 새 키로 서명을 전환한 뒤 이전 공개키를 유지하거나 폐기할 수 있습니다. 글·계정 비밀번호를 변경하면 관련 이전 토큰을 무효화합니다.
keys:init → keys:rotate → keys:retire · 개인키는 Git·배포 ZIP 제외
04 / SQL 리포트사전 집계와 기간 경계
게시글·댓글을 CTE에서 작성자별로 집계한 후 회원에 LEFT JOIN해 행 곱셈을 막았습니다. COALESCE로 활동 없는 회원을 포함하고 DENSE_RANK로 동점 순위를 계산합니다. KST 날짜를 기존 DATETIME 저장 시간대에 맞춰 시작 포함·종료 제외로 비교합니다.
post_counts / comment_counts 사전 집계 → users LEFT JOIN 집계 결과 → DENSE_RANK
05 / 검증 · 배포독립 DB 회귀검사와 CI
테스트마다 별도 DB·키를 생성해 앱 DB와 분리합니다. ID 우회·기본 키 위조·만료·비밀번호 변경·기존 스키마 변경을 검사하고, 리포트의 중복 집계·윤일·기간 경계도 검증합니다. 운영 DB 자동 동기화와 기본 관리자 자동 생성을 비활성화했습니다.
MySQL 8 통합 테스트 30개 = 리포트 18개 + 비공개·보안 12개 · backend / frontend 빌드
실제 MySQL 8 API 테스트에서 확인한 사례
검증 입력
확인 결과
한 회원의 게시글 2개 + 댓글 3개
2건 / 3건 / 합계 5건 · JOIN 중복 방지
기간 시작 · 종료 직전 · 종료 시각
포함 · 포함 · 제외 · UTC 저장 시간대도 검사
다른 회원·관리자가 비공개 글 ID 사용
목록·본문·댓글 접근 차단 · 올바른 비밀번호만으로 열람 불가
글·계정 비밀번호 변경, 토큰 만료·변조
기존 확인 토큰·잘못된 인증 버전 거부
2026.10.16 로컬 MySQL 통합 테스트와 양쪽 빌드 통과 기준입니다. 현재 서비스는 운영하지 않습니다. 키 관리는 로컬 파일 방식이며 외부 KMS 연동이나 DB 본문 암호화를 의미하지 않습니다. 비밀번호 시도 제한은 단일 프로세스 메모리를 사용합니다.
AWS 운영 구조도와 연결 경로 보기+
교육 과정에서 Nginx의 /api 프록시, NestJS·PM2와 MySQL 연결, Jenkins 배포 자동화와 PM2 → pm2-metrics → Prometheus → Grafana 경로를 구성했습니다. 아래 설계도는 서버의 역할과 요청·메트릭 경로를 보여주며 부하 테스트나 무중단 운영을 증명하는 이미지는 아닙니다.
서울 ASOS 관측자료로 어제의 확정 날씨, 오늘의 시간별 관측, 내일의 평균기온을 한 화면에 제공합니다. 일자료 기반 예측과 시간자료 기반 보정을 분리하고 계산 근거를 API·화면·DB에 함께 남긴 서비스입니다.
맡은 역할 · 4인 팀기상 데이터의 수집 시점·결측을 점검하고 62개 후보 중 44개 변수를 선별했습니다. 학습과 API의 입력 구성을 맞추고 모델 입력·예측 API를 연결했습니다. 예측값뿐 아니라 입력 조건과 처리 근거가 화면에서 확인되도록 연결했습니다.
01 / 과제
일자료가 확정되는 시점과 예측 대상일을 맞추고, 외부 API 오류나 시간자료 부족 상황에서도 유효한 결과를 제공해야 했습니다.
02 / 구현 과정
확정 일자료로 기본 예측을 만들고, 21시 이후 관측 조건을 충족할 때만 최근 72시간 자료로 잔차를 보정합니다. 수집 실패·조건 미충족 시 기본 예측을 유지하고 적용 사유를 표시합니다.
03 / 결과물
React 분석 창에서 기본값·보정량·최종값, 입력 기간과 결측 대체 내역을 확인할 수 있습니다. 모델 버전과 입력 스냅샷을 MySQL에 저장해 같은 날의 기본·보정 예측을 구분합니다.
조회·재예측 요청React → FastAPI
→
관측·입력 검증ASOS · 수집 시점
→
기본값·조건부 보정CatBoost · LightGBM
→
저장·조회 응답MySQL → React
예측 API와 데이터가 연결되는 구조
개인 담당은 수집 시점·결측 점검, 변수 선별과 모델 입력·예측 API 연결입니다. 아래 구조는 이 작업이 이어지는 현재 서비스의 처리·저장 방식입니다.
01 / API·예외 처리사용할 수 있는 관측만 예측에 반영
관측 조회·예측 실행·이력 조회를 구분합니다. 관측소와 대상일을 검사하고, 시간자료 수집 실패나 관측 부족 시 기본 예측을 유지합니다. 기본 예측을 만들 수 없는 경우에는 503으로 실패를 알립니다.
POST /api/v1/predictions/run · GET /api/v1/predictions/history
02 / DB 모델링예측값과 계산 근거를 함께 저장
model_versions와 temperature_predictions를 모델 버전으로 연결합니다. 관측소·대상일·모델 버전의 복합 유일 키로 upsert하고, input_snapshot JSON에 입력 기간·결측 처리·보정 근거를 남깁니다.
model_versions 1:N temperature_predictions · input_snapshot JSON
03 / 실행·점검외부 관측·모델·DB 상태를 구분
Docker Compose에서 화면·API·MySQL을 분리하고 healthcheck를 통과한 서비스부터 연결합니다. 관측 응답의 10분 캐시와 패널별 오류 표시로 외부 요청 실패가 다른 결과 조회까지 막지 않도록 구성합니다.
React / Nginx · FastAPI · MySQL · GET /health
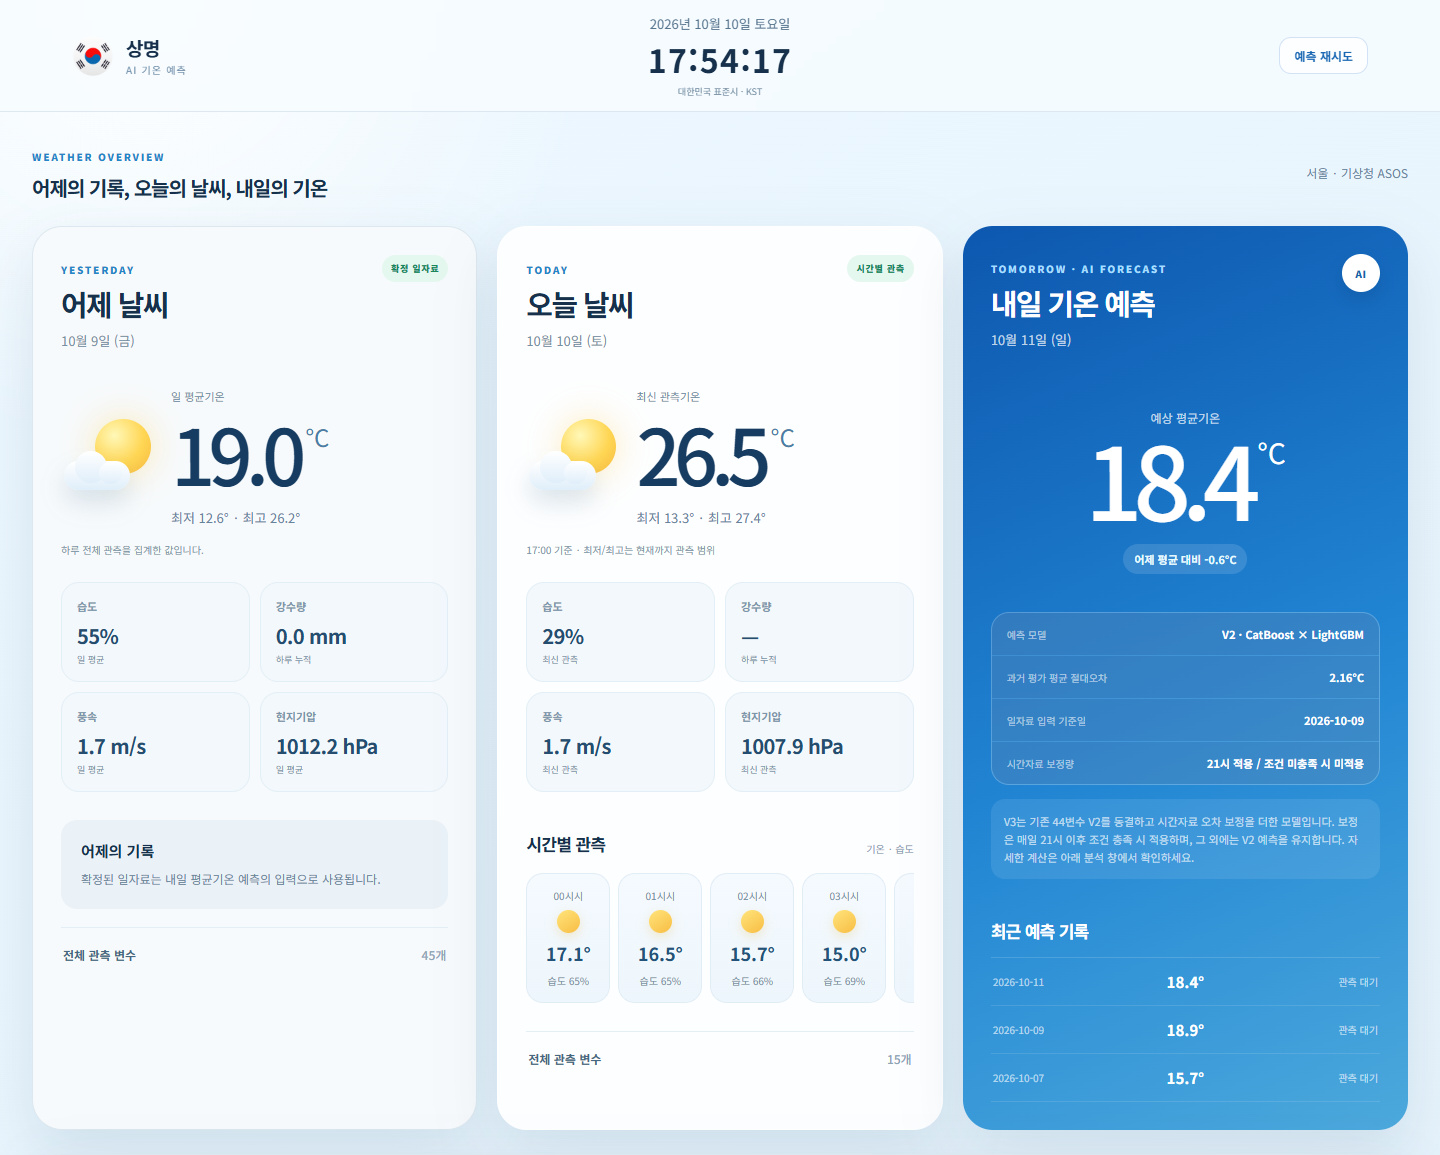
웹 구현 결과 · 관측과 예측을 한 화면에 2026.10.10 17:54 KST 실행 화면. 어제 확정 일자료·오늘 시간별 관측·내일 평균기온 예측을 구분하고, 카드 하단의 시간별 관측·모델 정보·예측 이력까지 연속 촬영했습니다. 이 화면은 시간자료 보정 적용 전 기본 예측 결과입니다. 이미지를 누르면 원본 크기로 볼 수 있습니다.
관측 공개 지연 1시간을 가정한 과거 자료 내부 평가
동일 조건 평가
기본 일자료
시간자료 결합
검증 MAE
2.361°C
1.610°C
평가 MAE
1.928°C
1.343°C
평가 RMSE
2.574°C
1.835°C
검증 364일(2025년), 평가 277일(2026년). 2026년 자료는 이전에도 열람한 구간으로, 향후 실서비스 성능과 구분합니다.
구현과 검증 자세히 보기+
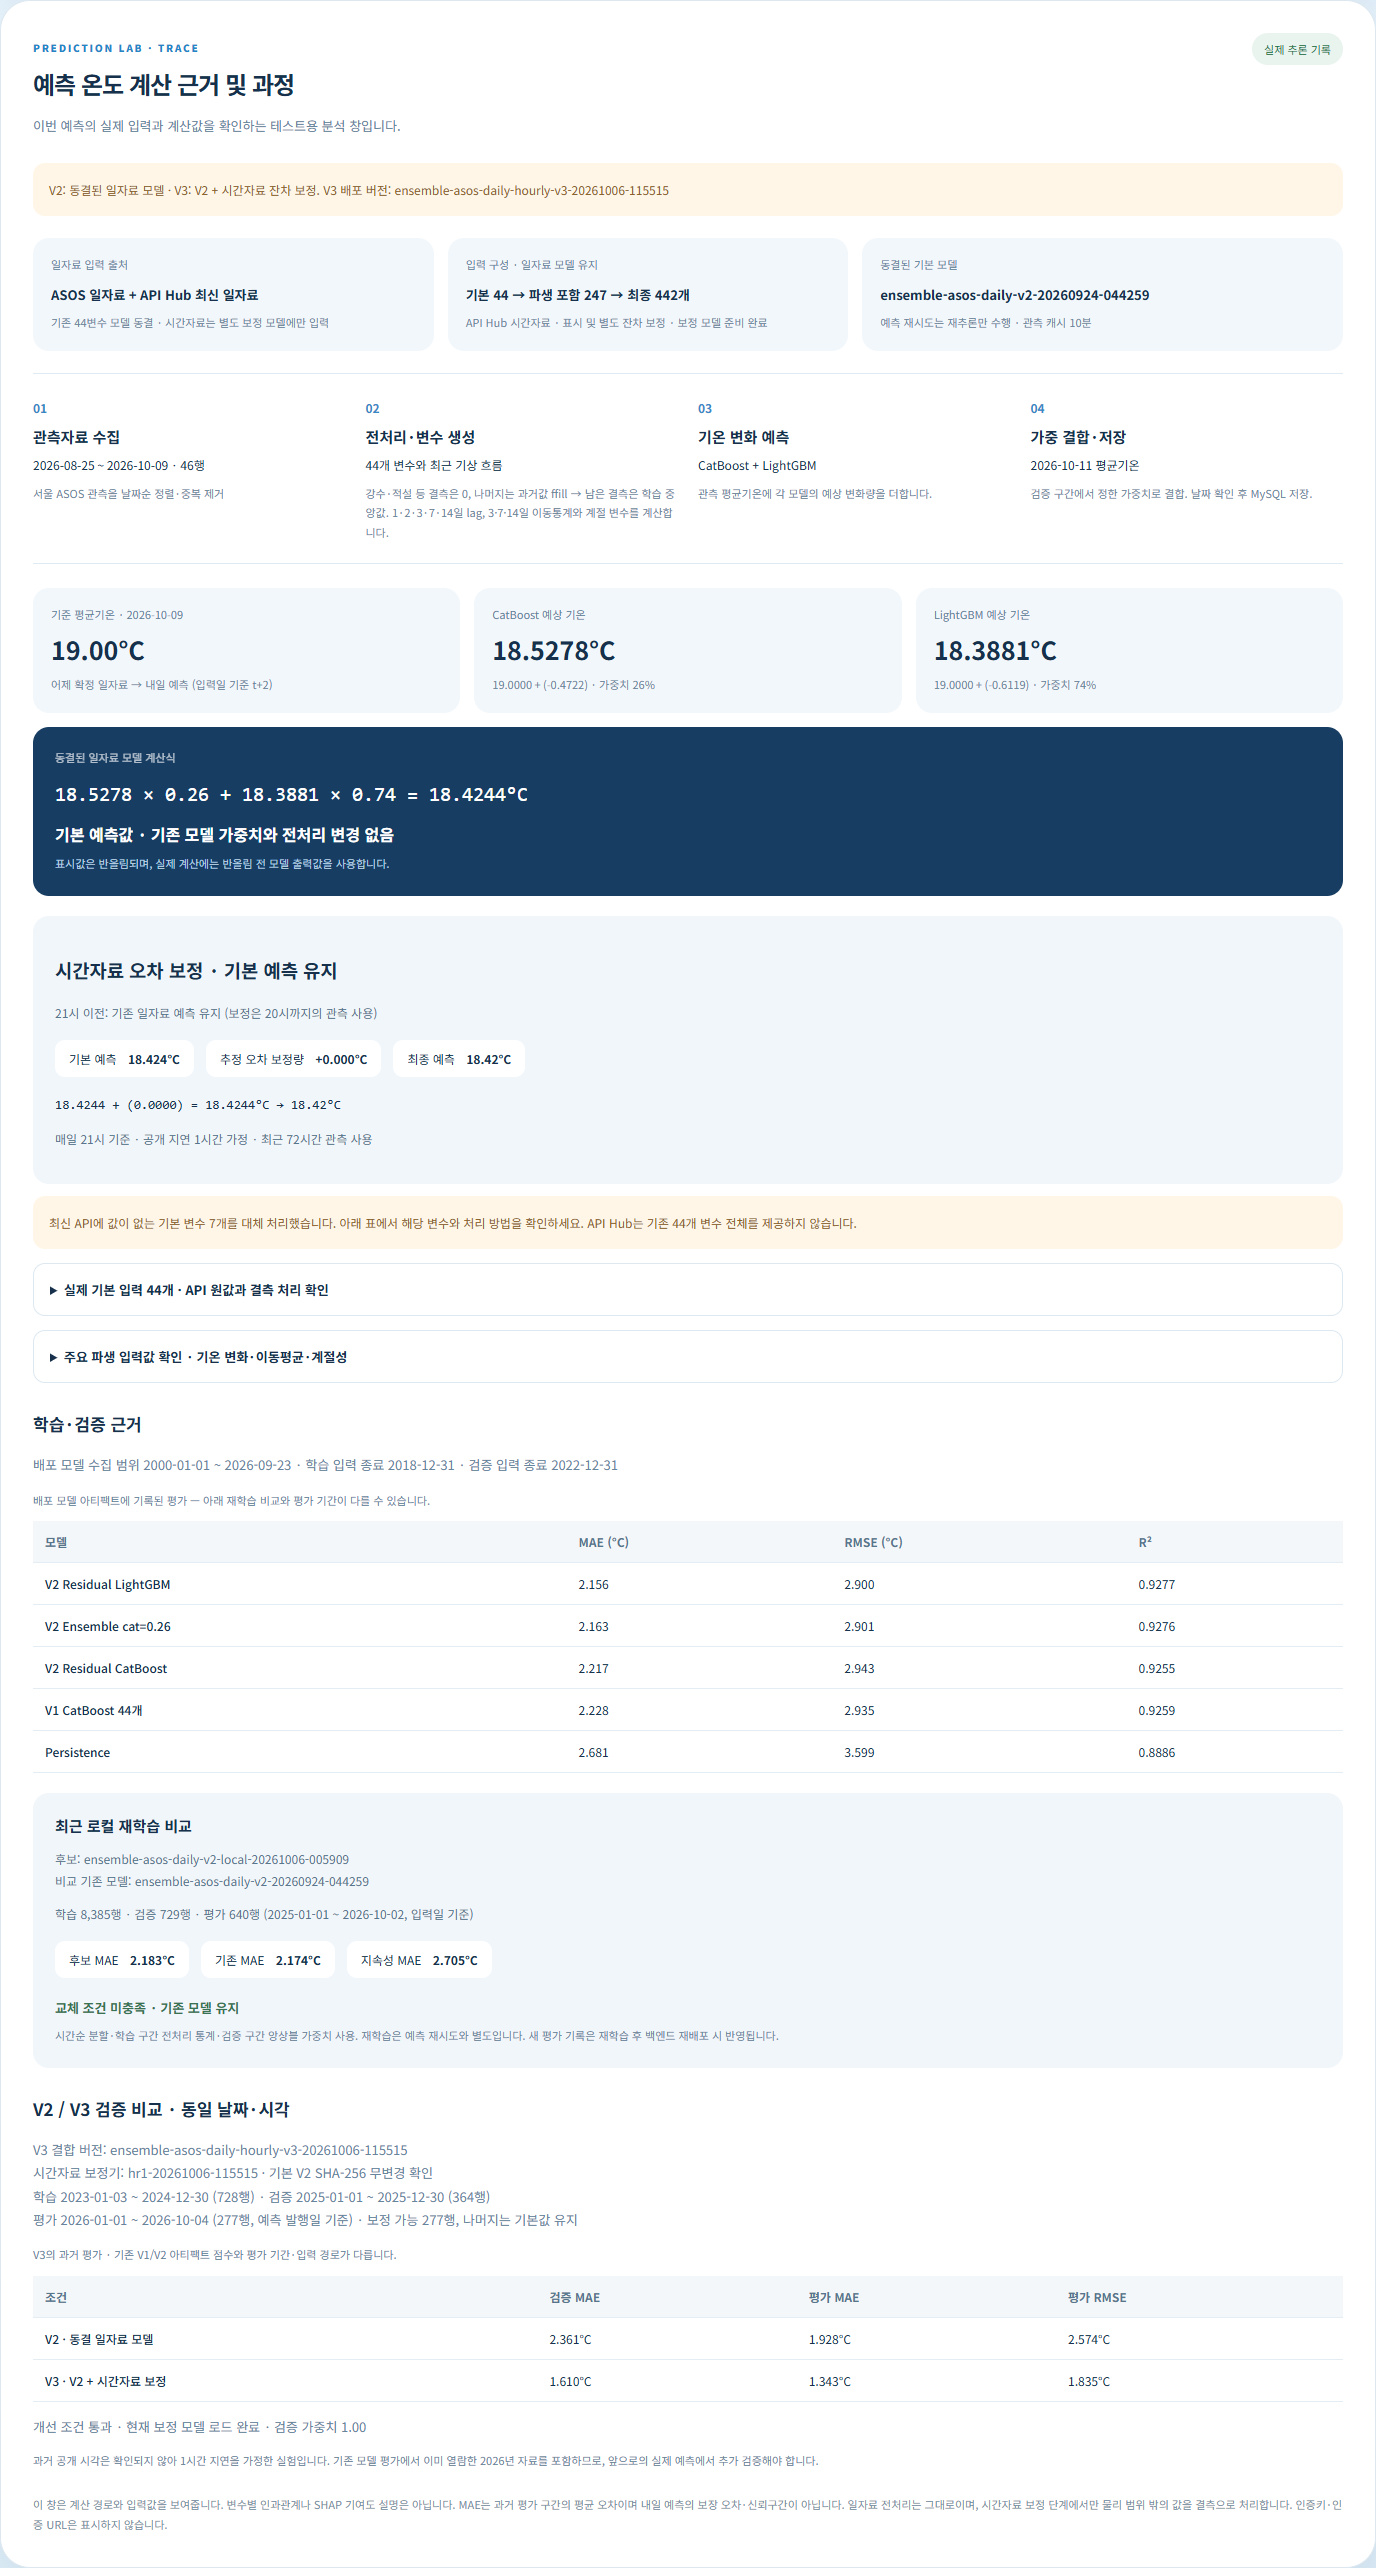
웹 구현 결과 · 계산 과정부터 평가 표까지 이어지는 분석 창 2026.10.10 17:54 KST 실행 화면. 관측 수집·전처리·기본 예측 계산·시간자료 보정과 모델 평가 표까지 전체 분석 영역을 연결했습니다. 과거 자료의 내부 평가이며, 위 관측·예측 화면의 당일 정확도와는 구분합니다. 이미지를 누르면 원본 크기로 볼 수 있습니다.
사용할 수 있는 관측만 입력
21시 기준 20시까지 관측만 사용해 공개 지연 1시간을 반영
기온 관측률 80% 이상, 최근 24시간 유효 관측 20개 이상, 최신 관측 지연 1시간 이내
기존 일자료 모델은 동결하고 시간자료 보정 모델을 별도로 연결
API·저장·실행 확인
예측 재시도는 재추론이며 관측 응답에는 10분 캐시 적용
관측 요청 일부가 실패해도 다른 날씨 패널과 모델 근거는 독립 표시
날짜·모델 버전별 upsert와 input_snapshot JSON으로 예측 이력 관리
저장소 검증 기록: 테스트 35개 통과, Docker 실행·health·대시보드·DB 이력 일치
실행 점검은 21시 이전 기본 예측 경로입니다. 21시 이후 실관측 보정 적용은 과거 평가와 별도로 확인해야 합니다.
React 19TypeScriptFastAPIMySQLTF-IDF · LREuroBERTOllama · EXAONEGPT-4o-miniOpenAI Responses APIMake 연동 준비
Kaggle ISOT·WELFake의 영어 뉴스로 두 분류기를 학습·비교하고, Ollama 기본 요약과 GPT 추가 요약을 연결한 뉴스 워크스페이스입니다. React에서 기사를 관리하고 FastAPI가 AI를 직접 호출하며, MySQL에 원문 버전·분석 결과·토큰 사용량을 저장합니다.
맡은 역할 · 4인 팀Kaggle 데이터 전처리와 학습·검증 데이터 분리, LLM 뉴스 요약 구현을 담당했습니다. 중복·누수를 점검하고 요약을 기사 분석 흐름에 연결했습니다. 후속 확장에서는 기존 로컬 요약을 유지하면서 GPT API 추가 요약과 Make 연동용 파이프라인을 구축했습니다.
01 / 과제
중복·출처 표현의 영향을 줄인 같은 데이터로 모델을 비교하고, 분류·요약 결과를 동일 기사 버전 기준으로 확인해야 했습니다.
02 / 구현
본문 해시·연결 그룹으로 데이터를 분리하고 EuroBERT 문맥 특징을 LR에 추가했습니다. Ollama 요약 아래 GPT 선택 버튼을 연결했습니다.
03 / 결과
두 모델의 판정·단어별 기여도와 두 LLM 요약을 웹에서 조회합니다. 원문 스냅샷·작업 상태·GPT 토큰을 DB 이력으로 남깁니다.
기사·분석 요청React → FastAPI
→
요청 시점 저장원문 버전 · 작업 상태
→
분류·요약 실행두 분류기 · Ollama / GPT
→
결과 저장·조회MySQL → React
01 / 분류 · 기존 LR을 보존하고 Transformer 특징 추가
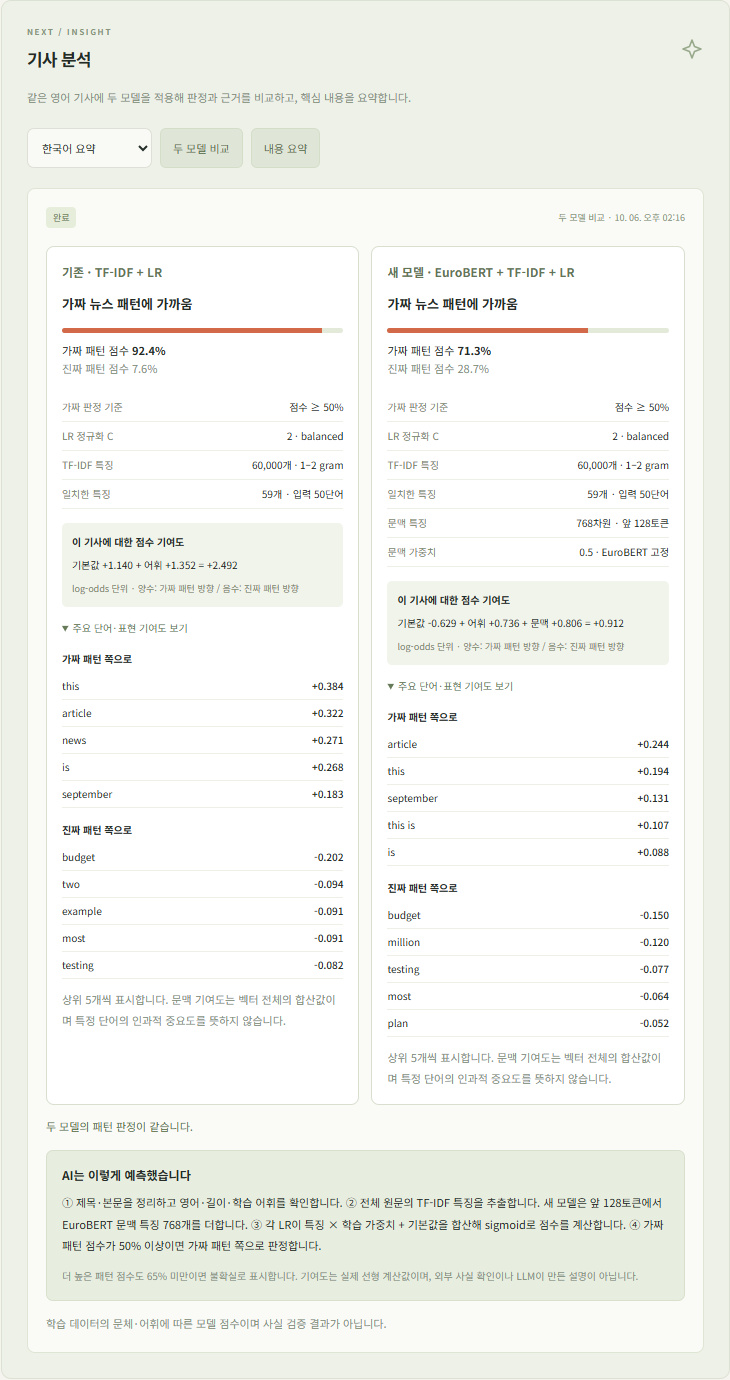
기존 TF-IDF + 로지스틱 회귀를 유지하고, 고정 EuroBERT-210M의 768차원 문맥 벡터를 더한 파생 LR을 학습했습니다. EuroBERT 전체를 미세조정한 것이 아니라 특징 추출기로 사용했습니다. 같은 기사에서 두 모델의 판정·점수·단어별 기여도와 실제 파라미터를 함께 표시합니다.
본문·연결 그룹이 겹치지 않는 동일 테스트 6,154건
평가 지표
TF-IDF + LR
EuroBERT + TF-IDF + LR
정확도
96.34%
98.16%
Macro F1
0.9629
0.9814
정확도 +1.82%p. 모델 선택은 검증 Macro F1 기준입니다. 과거 영어 뉴스 내부 평가이며 최신·한국어 뉴스 성능이나 사실 확인 정확도를 뜻하지 않습니다.
같은 기사 버전의 두 모델 결과와 계산 근거. 2026.10.10 실제 저장 결과를 조회한 화면입니다. 개별 기사의 패턴 점수는 위 정확도 지표와 구분합니다.
02 / 뉴스 요약 · Ollama 기본, GPT LLM 선택
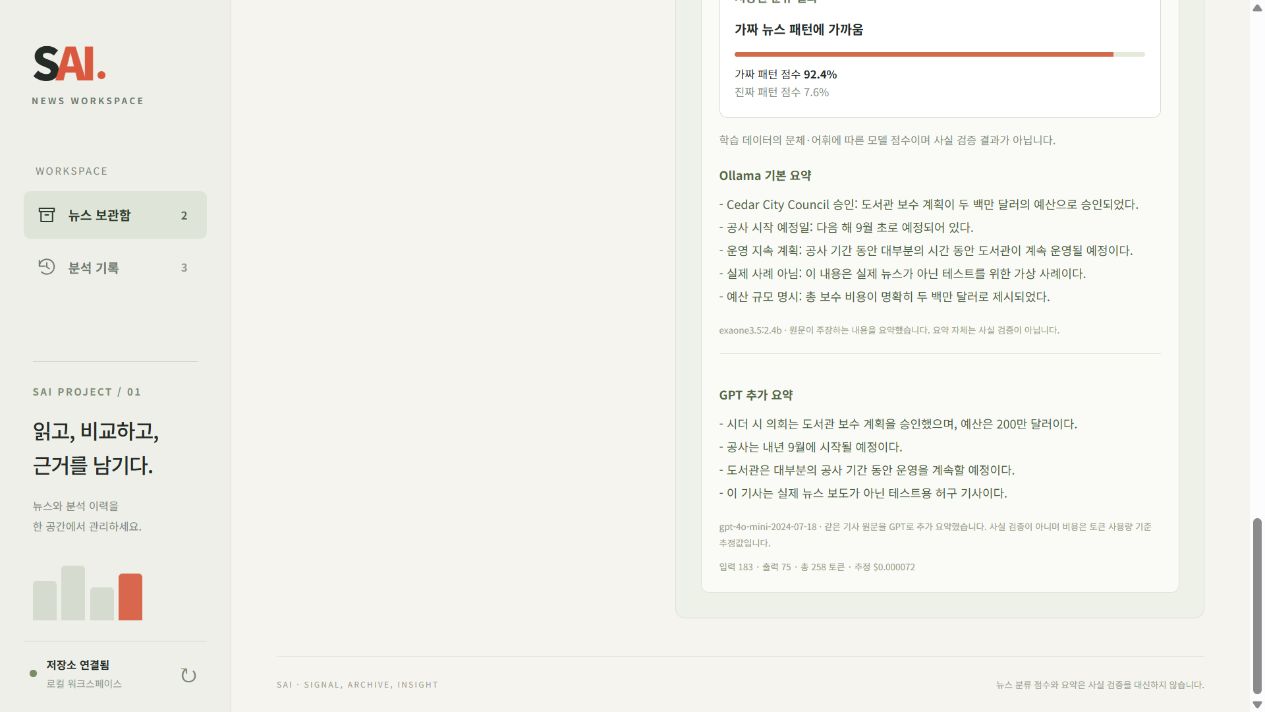
Ollama 로컬 LLM을 기본으로 유지하고 GPT-4o-mini를 추가 요약 모델로 도입했습니다. 먼저 로컬 요약을 읽고, 필요한 기사에만 GPT를 호출해 API 사용량을 제어합니다. 두 요약은 같은 원문·버전·언어 스냅샷을 기준으로 생성합니다.
기본 요약
Ollama · EXAONE 3.5 2.4B
기존 내용 요약 버튼으로 실행합니다. 한국어·영어 출력과 긴 기사 분할·통합을 지원합니다.
사용자 선택
OpenAI · GPT-4o-mini
Ollama 결과 아래 GPT로 추가 요약 버튼을 클릭할 때만 호출합니다. 원문을 별도로 요약하고 기존 결과 아래 표시합니다.
React 버튼 → FastAPI → OpenAI Responses API → MySQL → 추가 결과 UI
API 키는 백엔드에만 보관합니다. 추가 요약·입력/출력 토큰·추정 비용을 저장하고, 완료 결과를 재사용해 같은 분석의 중복 호출을 막습니다. 실패 시 자동 호출을 반복하지 않고 사용자가 명시적으로 재시도합니다. 한국어 출력은 영어 원문에서 직접 요약하며 별도 번역 API를 호출하지 않습니다.
실제 GPT 연동 확인 · 2026.10.11 가상 도서관 기사 1건으로 요약·MySQL 저장·웹 출력을 확인했습니다. 성공 생성 호출 1회, 입력 183 + 출력 75 = 총 258토큰, 추정 비용 $0.00007245입니다. 실행 확인이며 요약 품질의 비교 평가 결과는 아닙니다.
03 / SaaS 연동 · Make 파이프라인 구축, 현재 비활성
연동 코드 구축 · 자동화 비활성
Make·Google Sheets 자동화를 위한 인증 API, 중복 요청 제어와 워크플로 계약·실행 클라이언트를 구축했습니다. 현재는 웹에서 FastAPI를 직접 호출해 분류·요약을 처리할 수 있으므로 Make는 활성화하지 않았습니다.
현재 · 웹 직접 호출
React → FastAPI → AI → MySQL 사용자가 기사와 분석 요청을 직접 관리합니다.
향후 · Make 자동화
Google Sheets → Make → FastAPI → 시트 결과 기록 구축한 처리 API와 저장 구조를 재사용합니다.
향후 계정·접근 경로·시나리오 연결을 완료하고 가동하면 뉴스 입력·요약·결과 기록 자동화를 사용할 수 있습니다. 현재 AUTOMATION_ENABLED=false이며 실제 Make 시나리오 배포·Google OAuth·스케줄 실행은 수행하지 않았습니다. 클라우드 Make에서 호출할 인증된 HTTPS 경로도 설정해야 합니다.
API·DB · 분석 당시의 근거를 다시 조회하는 구조
01 / 작업 상태긴 AI 처리를 조회 가능한 작업으로
분석은 202로 접수하고 queued·running·completed·failed 상태로 조회합니다. AI 호출을 직렬화하고 대기·진행은 최대 10개로 제한하며, 재시작으로 중단된 작업은 실패 처리합니다.
POST /api/articles/{id}/analyses → GET /api/analyses/{id}
02 / DB 모델링원문 버전과 Ollama·GPT 결과 보존
기사마다 여러 분석을 연결하고 요청 당시 원문·버전을 복사합니다. 기존 분류·Ollama JSON과 GPT 추가 요약·토큰을 별도로 저장해 기사 수정 이후에도 당시 결과를 조회합니다.
articles 1:N analyses · gpt_summaries · 원문 스냅샷 · JSON
03 / 일관성수정 충돌·중복 호출·DB 점유 제어
expected_version이 다르면 409로 응답하고 분석 중 기사는 삭제를 막습니다. 느린 추론 동안 DB 세션을 반환한 뒤 결과를 저장하며, GPT 완료 요청과 자동화 request_id 재제출에는 기존 결과를 반환합니다.
조건부 UPDATE · 추론 전후 세션 분리 · 요청 재사용
데이터·구현·검증 자세히 보기+
동일 데이터 기준 모델 비교
고유 기사 61,545건: 학습 49,236 / 검증 6,155 / 테스트 6,154
TF-IDF 60,000차원 + 고정 EuroBERT 768차원, 최종 LR 학습
검증 Macro F1로 모델 선택, 동일 테스트 기사로 평가
ONNX·OpenVINO와 원본 특징 대조, GPU 코사인 유사도 0.999 이상
웹·LLM·DB 검증
Python 단위·API 테스트 60개와 React 빌드 통과
실제 MySQL의 한글·이모지·긴 본문·JSON 저장 및 재조회 확인
모의 GPT로 성공·실패·토큰·중복 제어 경로 테스트
실제 GPT 1건: 요약·258토큰·비용 저장과 UI 확인
Make 인증·비활성화·중복 입력 코드 검증, 외부 SaaS 가동은 미실행
분류는 영어 뉴스 문체·어휘 패턴 판정이며 외부 사실 검증이 아닙니다. EuroBERT는 고정 특징 추출기, EXAONE·GPT는 별도 요약 모델입니다. 요약의 날짜·수치·주장·누락은 원문과 대조해야 하며 작업 실행기는 단일 FastAPI 프로세스 기준입니다.
3D 공간에서 작품을 배치하고 탐색하는 교내 캡스톤 팀프로젝트입니다. 분할 GLB 자산을 웹에서 불러오고 작품 배치·추천 결과를 탐색 화면으로 연결했습니다. 현재 서비스는 공간·작품 관리, 공개 전시 조회, 작품 설명의 버전 관리까지 연결합니다.
본인 기여 · 3인 팀 3인 팀에서 작품 배치 알고리즘과 DB·백엔드·프론트엔드 연동을 맡았습니다. 모델 용량·웹 호환성 제약에 맞춰 담당 알고리즘과 데이터 연결을 수정하고 팀원의 AI 모델을 웹 기능에 연결했습니다.
01 / 문제
모델 용량과 웹 호환성 문제로 핵심 기능을 시연하기 어려워지면서 기존 구현 방식을 조정해야 했습니다.
02 / 해결
팀원들과 품질·용량·호환성을 기준으로 Mesh 변환과 GLB 분할을 비교·적용했습니다. 맡은 배치 알고리즘과 DB·웹 연결을 새 자산 형식에 맞춰 수정했습니다.
03 / 결과
작품 배치와 공간 탐색이라는 공동 목표를 유지하며 핵심 기능을 기한 내 시연했고 A+를 받았습니다. 자산 처리·API·화면의 경계를 이해하는 경험을 쌓았습니다.
편집·배치 요청React · Three.js
→
API·알고리즘FastAPI · 배치 처리
→
공간·작품 저장SQLite · GLB 참조
→
다시 조회·렌더링공개 전시 · 편집 화면
담당한 배치 알고리즘·DB·웹 연동 구조
개인 담당은 배치 알고리즘과 DB·백엔드·프론트엔드 연결입니다. 3D 모델·AI는 팀 협업 결과이며 인증·공간 관리 항목은 현재 서비스에서 담당 기능이 연결되는 경계입니다.
01 / API 연동3D 장면의 편집값을 서버 데이터로 연결
배치 알고리즘과 화면·DB 연동을 맡아, 분할 GLB 형식에 맞춰 담당 기능을 수정했습니다. 현재 공간 편집 API는 구성요소와 작품 슬롯을 각각 저장하고, 조회 응답을 React·Three.js 장면으로 다시 연결합니다.
PUT /api/v1/curator/spaces/{id}/components · /slots
02 / DB 모델링공간·파일·슬롯·작품의 관계 표현
현재 SQLite 구조는 공간에 구성요소와 작품 슬롯을 연결하고, 슬롯과 작품을 배치 데이터로 연결합니다. 파일 참조와 위치·회전·크기를 함께 저장해 장면의 좌표와 작품 메타데이터가 이어지도록 구성합니다.
공간 1:N 구성요소 / 슬롯 · 슬롯 → 작품 배치 → 작품
03 / 인증·실행 환경편집 권한과 공개 조회 경계
현재 서비스는 JWT 로그인 후 역할·공간 소유권을 검사해 편집 요청을 처리하고 공개 전시 조회를 구분합니다. Docker 실행 환경에서 GLB 업로드·저장·편집 화면을 확인한 결과를 아래 이미지로 제시합니다.
JWT → 역할 검사 → 공간 소유자 / 관리자 검사
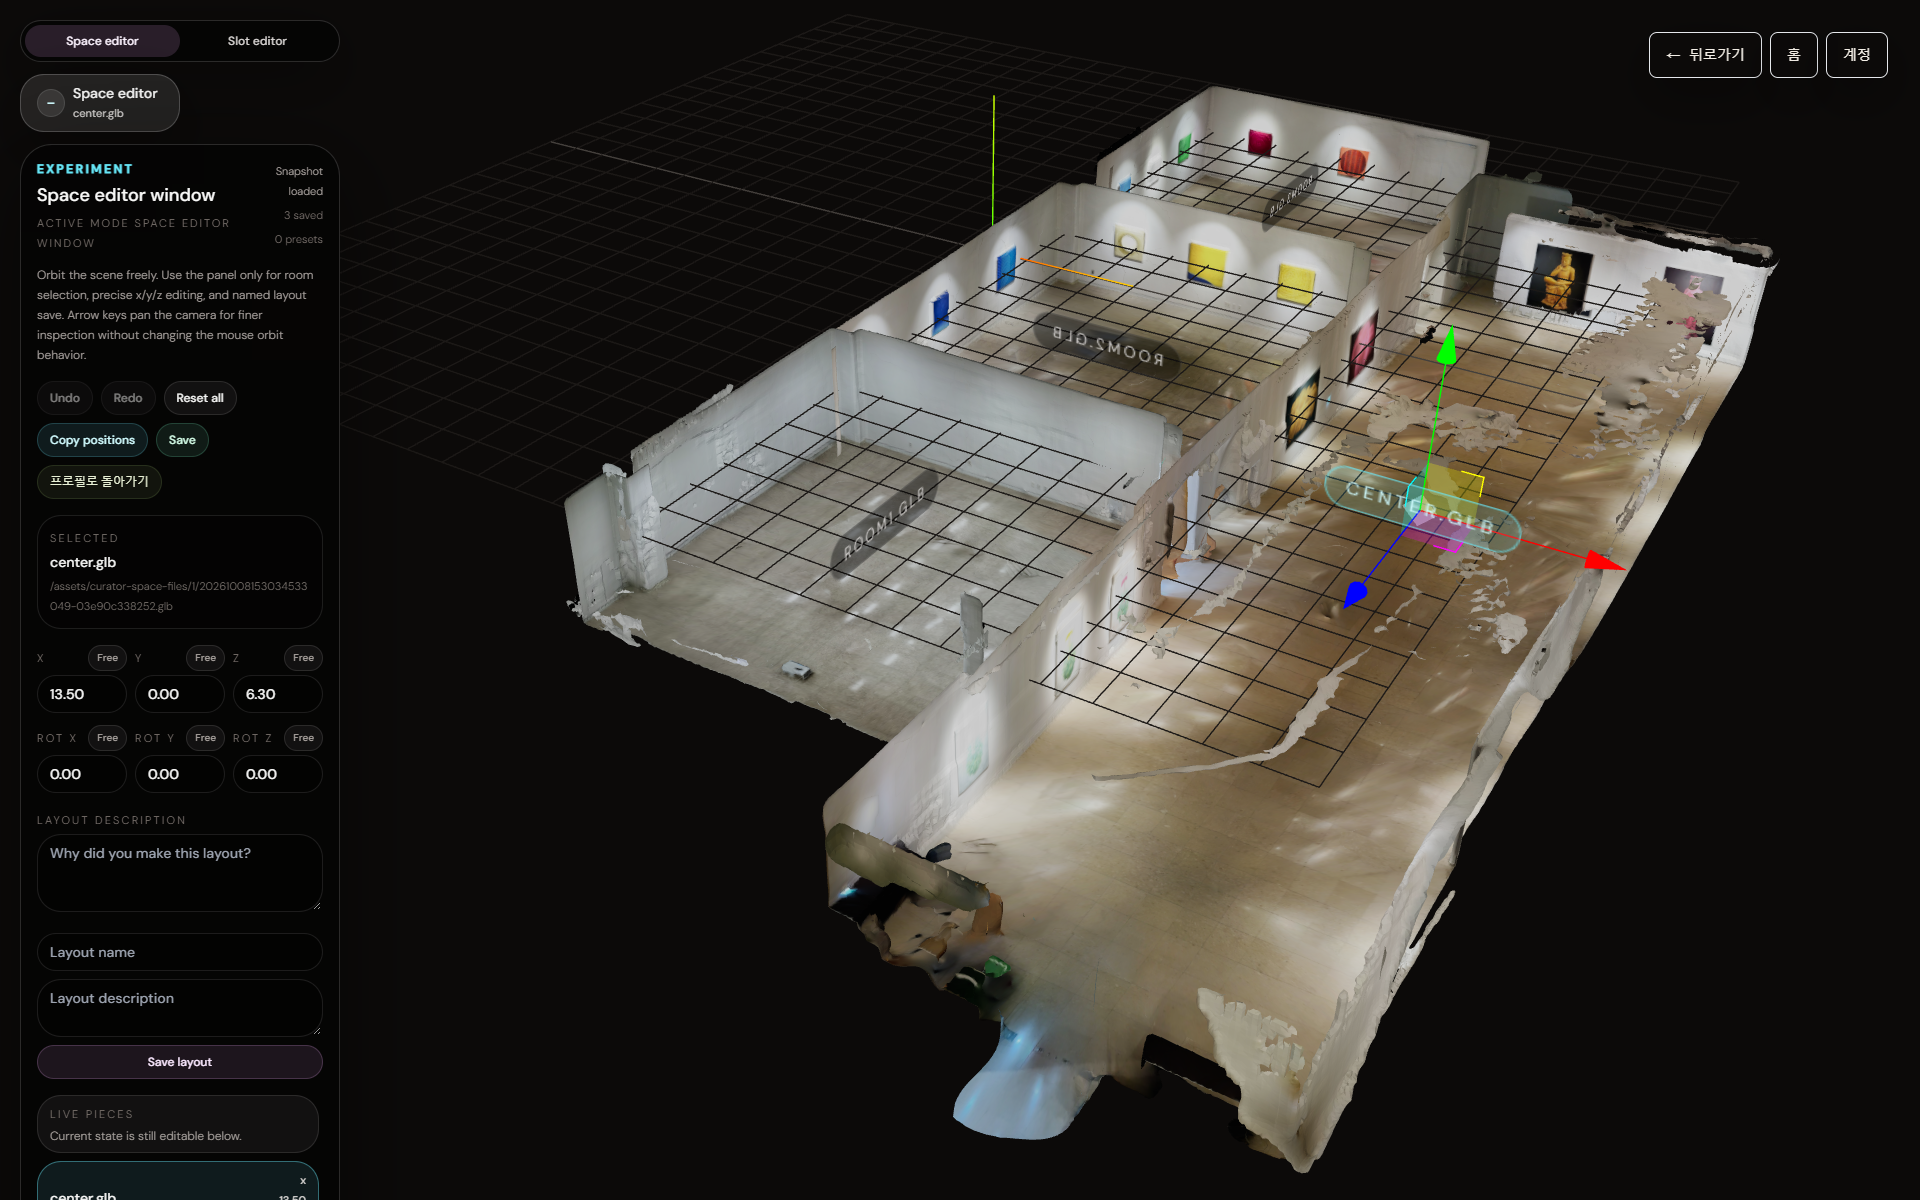
큐레이터가 공간을 구성하고 배치를 편집하는 화면
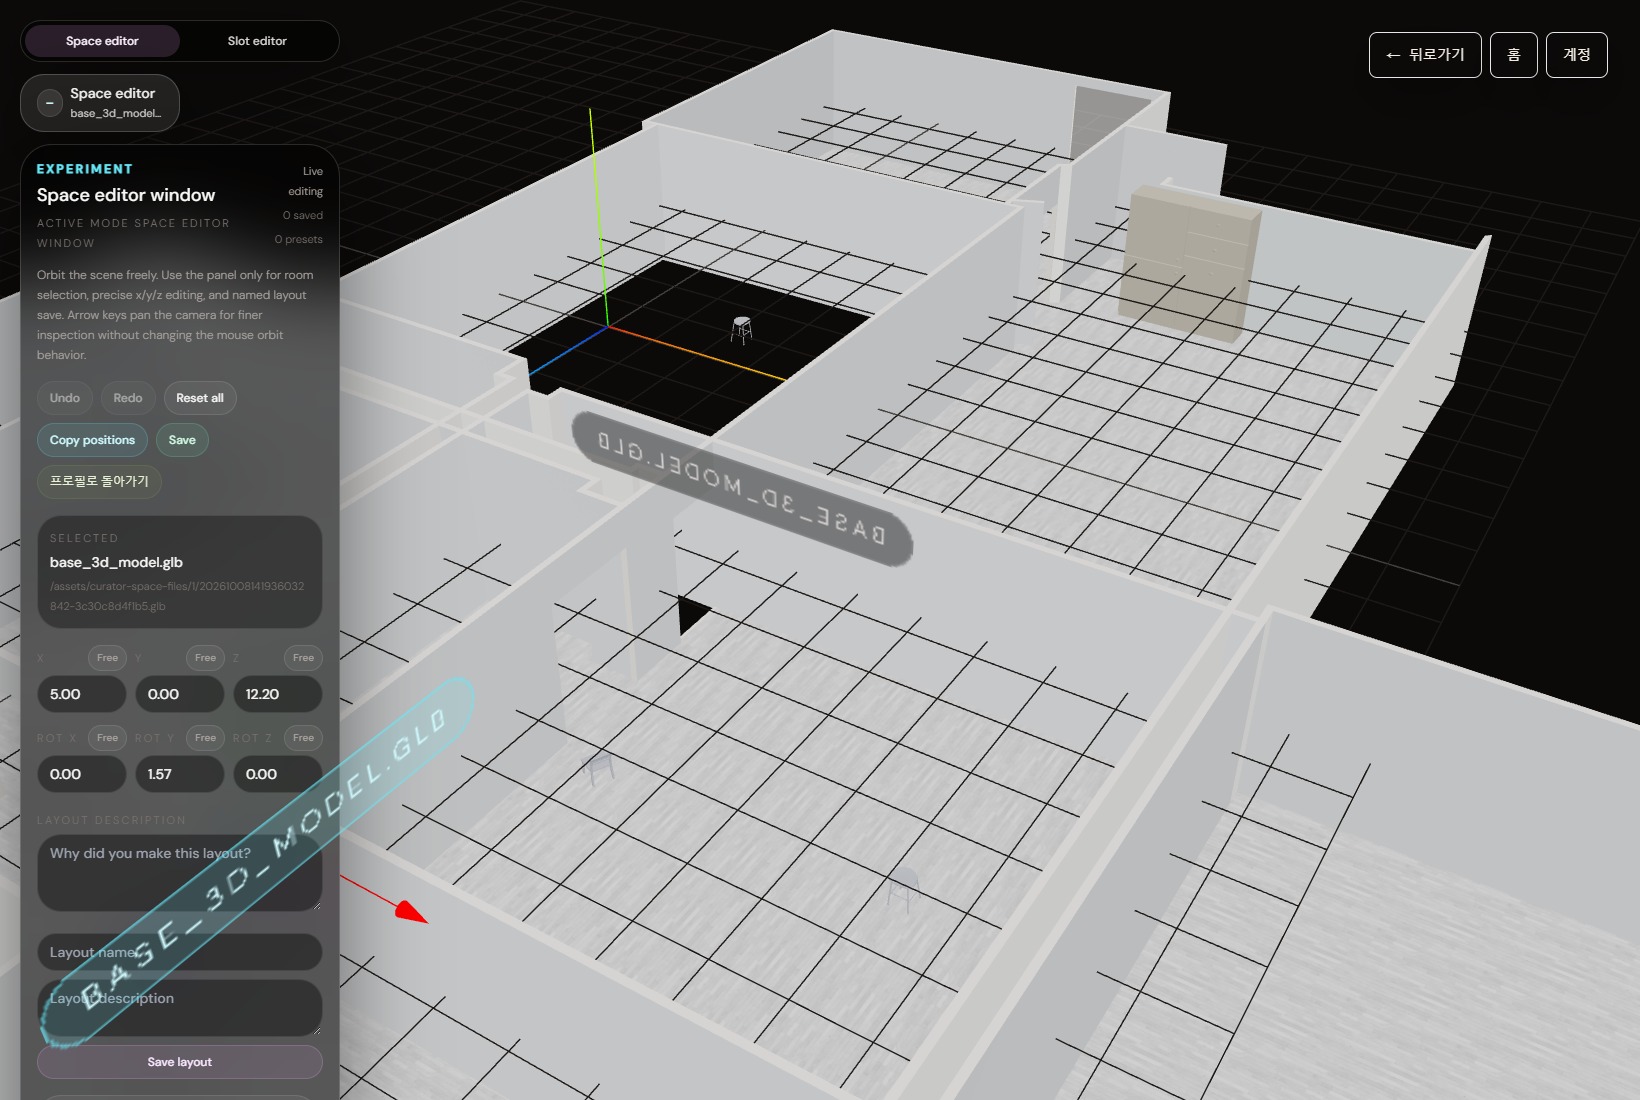
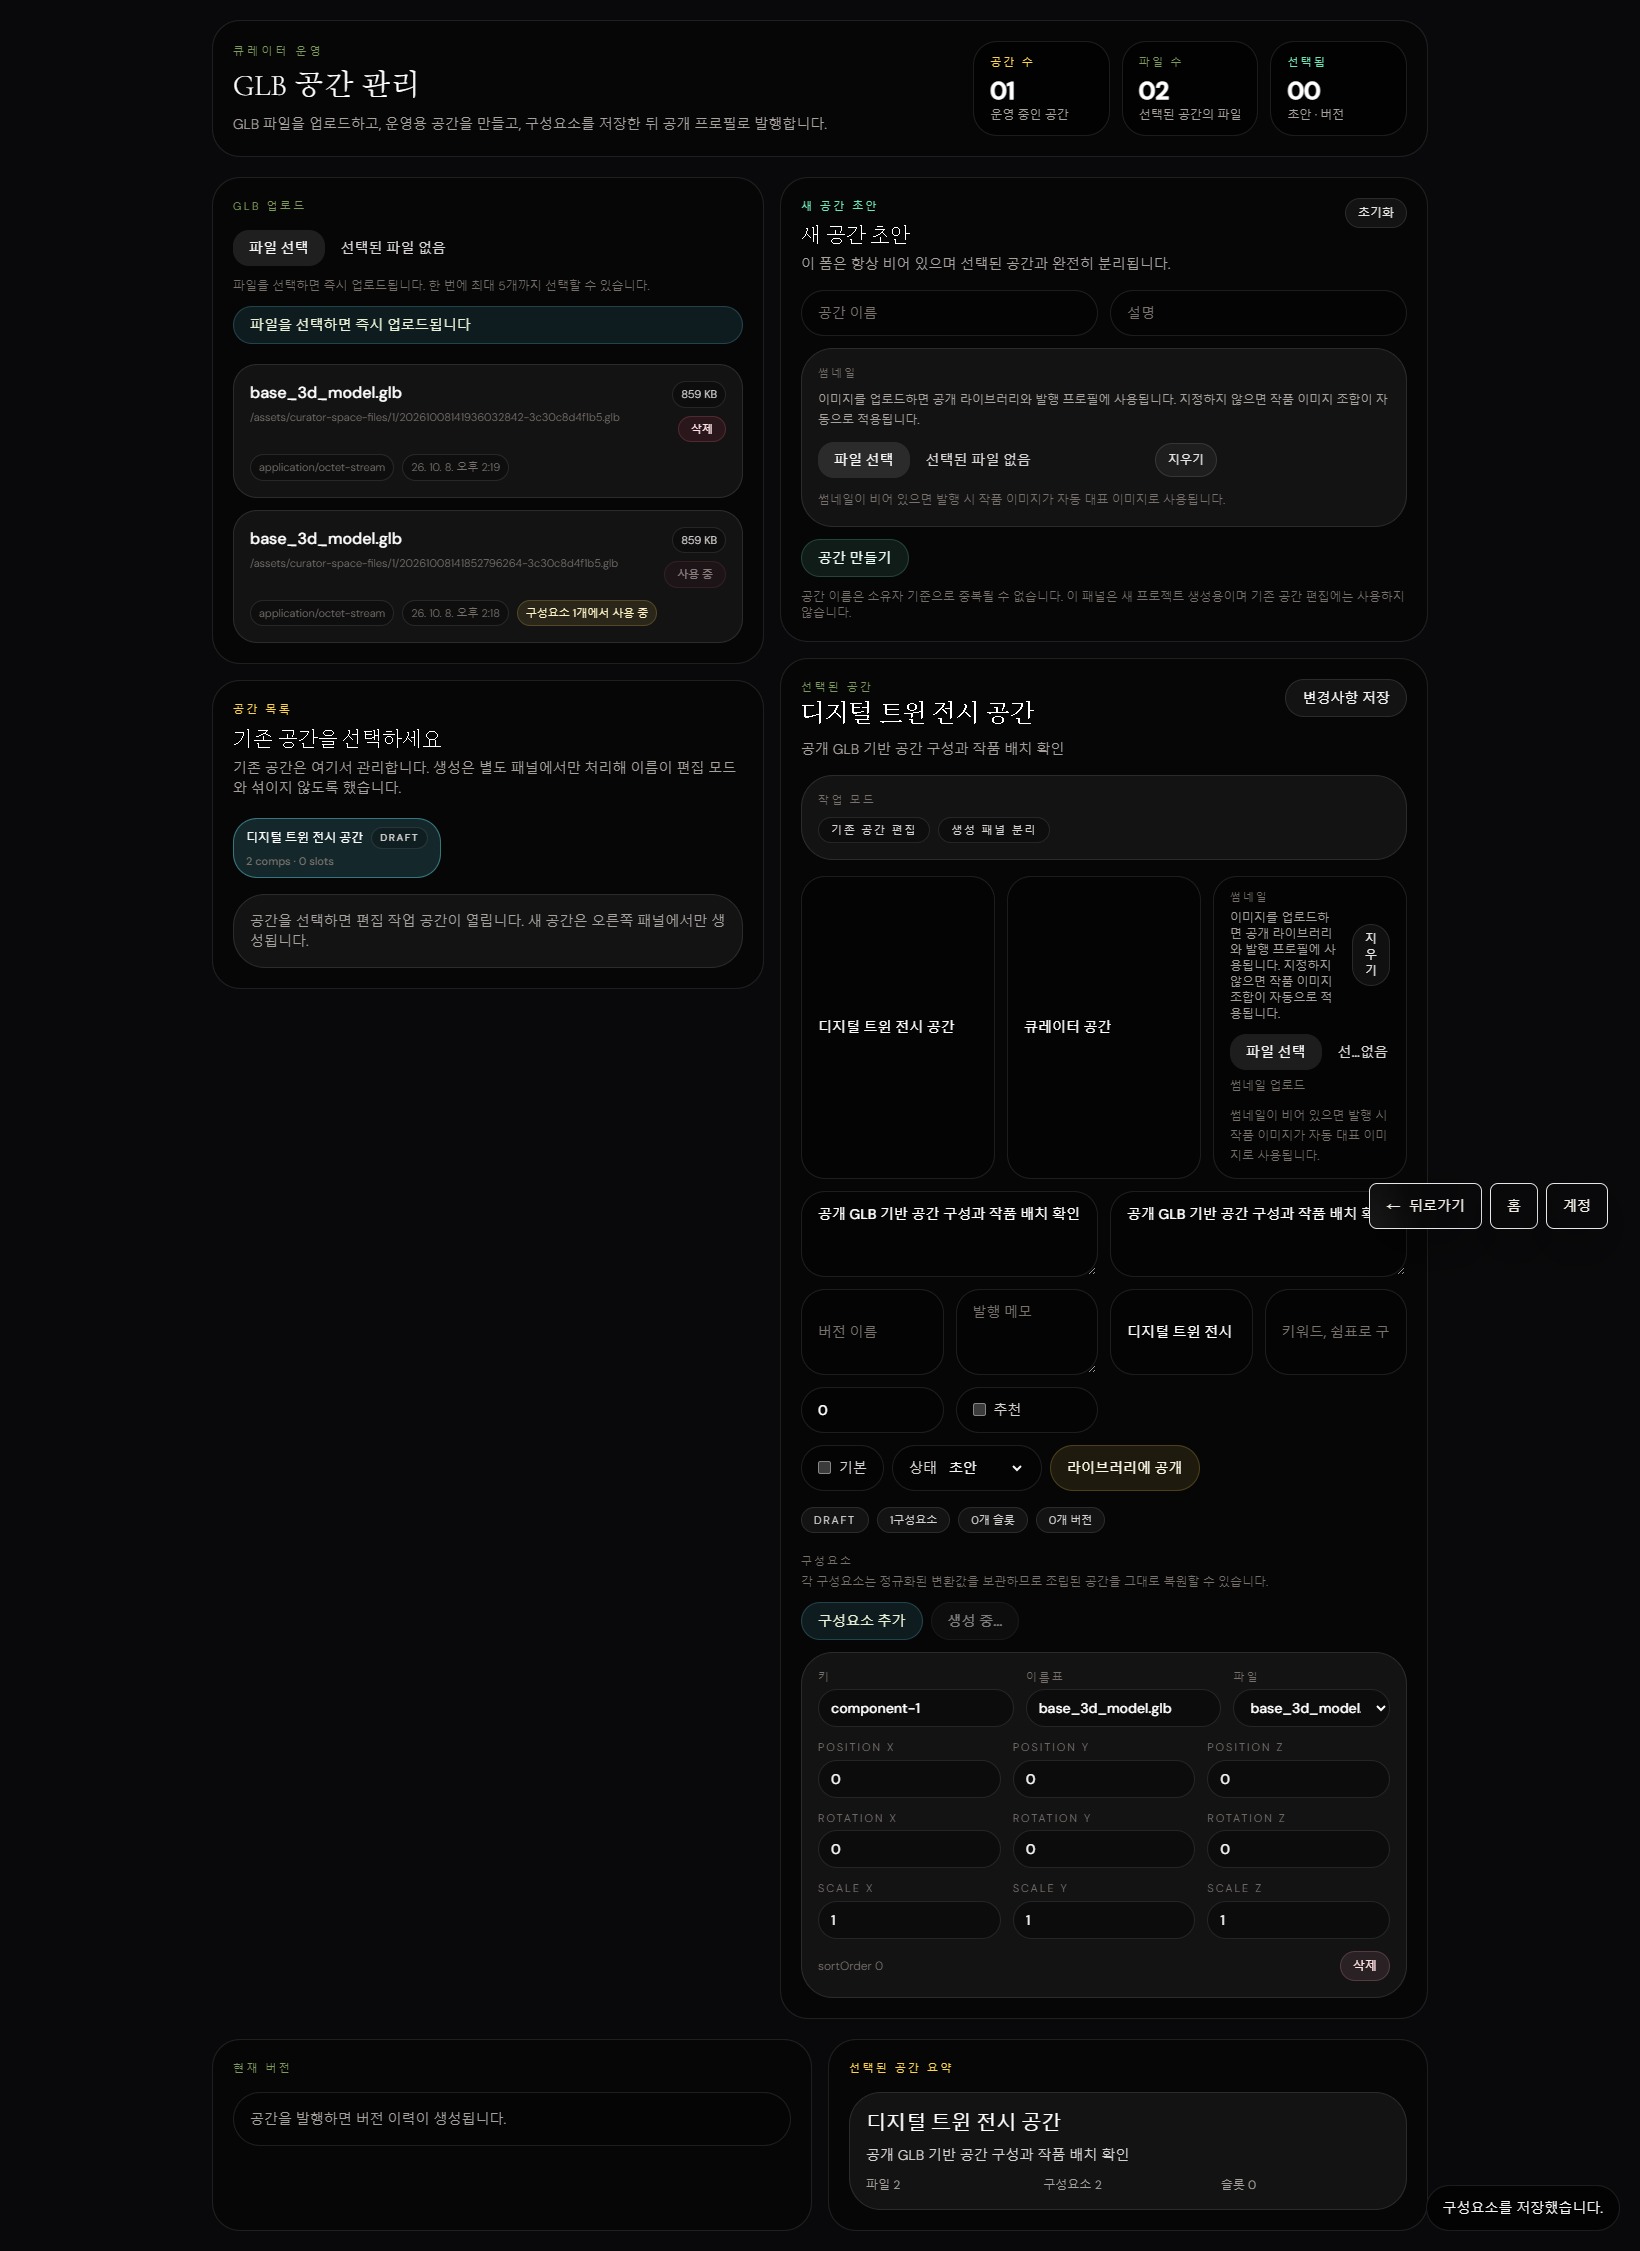
큐레이터 계정으로 로그인한 뒤 GLB 파일을 업로드하고 공간 구성요소를 저장했습니다. 3D 공간 편집기에서는 장면을 확인하며 위치·회전을 조정하고 레이아웃을 저장할 수 있습니다. 제가 담당한 배치 알고리즘·DB·웹 연동이 공간 관리와 편집 흐름으로 이어지는 결과물입니다.
3D 공간 편집기 · GLB 장면과 X/Y/Z 위치·회전 입력, 레이아웃 저장 패널
실제 미술관 Mesh 연결과 공간 편집
분할한 미술관 Mesh인 room1·room2·room3와 중앙 연결부 center를 하나의 장면으로 구성했습니다. 3인칭 시점에서 공간의 연결 상태를 확인하고, 편집 패널의 위치·회전 입력과 조작 도구로 배치를 조정할 수 있습니다.
실제 미술관 분할 Mesh와 중앙 연결부 · 큐레이터 공간 편집기에서 연결 상태와 위치·회전 조정 도구 확인(2026.10.09)
GLB 업로드·구성요소 저장 화면 보기+
공간 관리 · 파일 업로드, 구성요소 변환값과 저장 결과
공개 저장소의 서비스를 Docker로 실행하고 큐레이터 테스트 공간에서 캡처했습니다(2026.10.08–09). 3D 모델·AI 기능은 팀 협업 결과이며, 개인 담당 범위는 배치 알고리즘과 DB·웹 연동입니다.
구현과 판단 과정 자세히 보기+
팀 결과와 본인 역할
3D 모델 처리와 AI 모델은 팀 협업 범위입니다. 본인 담당은 작품 배치 알고리즘 및 DB·웹 연결이며, 팀의 변경 사항에 맞춰 담당 기능을 수정했습니다.
완성 기준
자신의 코드 구현에 그치지 않고 실제 화면에서 배치·탐색이 가능한지 확인했습니다. A+는 학업 평가 결과로, 성능 개선 수치와 구분합니다.
배치 결과를 전시 데이터로 연결
공간 구성 요소·작품 슬롯을 API로 저장하고 공개 전시 조회로 연결
작가 작품 등록·수정과 이미지 업로드, 액자형 GLB 생성 경로
추천 특징 상태·결과를 확인하는 API와 디버그 화면
현재 서비스의 콘텐츠 관리
작품 설명 생성·수정, 버전 목록과 현재 버전 선택
공개 상태 관리와 버전별 TTS 생성·재생 연결
JWT 로그인과 소유자·관리자 권한에 따른 수정·자산 접근
현재 코드의 서비스 기능을 소개한 내용입니다. 개인 담당은 위 배치 알고리즘·DB·웹 연동 범위이며 AI 생성·3D 모델은 팀 협업 결과입니다.
프로젝트별 맡은 역할과 GitHub 결과물을 함께 정리했습니다. 카드에서 구현 과정과 평가 근거를 확인할 수 있습니다.
06 / Activities
함께 배우고 성장한 경험
4인 팀 프로젝트
기상 예측 · 입력 기준부터 맞추다
교내 팀 프로젝트에서 기상 데이터의 수집 시점과 결측 여부를 점검하고, 62개 후보 중 44개 변수를 선별했습니다. 학습에 사용하는 변수와 API의 입력 구성을 맞추며 데이터 처리와 예측 기능을 연결했습니다. 네 명이 맡은 작업을 연결하는 협업을 통해 예측 기능을 완성했습니다. 이 과정에서 공동 결과물을 만들려면 각 작업의 입력 조건과 처리 기준부터 명확히 해야 한다는 점을 배웠습니다. 예측값뿐 아니라 어떤 시점의 데이터를 사용했는지도 함께 확인하는 습관을 길렀습니다. 프로젝트 역할과 결과 보기 →
4인 팀 프로젝트
SAI · 각자의 작업을 분류·요약 결과로 연결하다
교내 인공지능 동아리 SAI에서 Kaggle 뉴스 데이터로 가짜 뉴스 분류와 LLM 요약 프로젝트를 진행했습니다. 저는 데이터 전처리와 학습·검증 데이터 분리를 맡고, LLM 뉴스 요약 기능을 구현했습니다. 중복·누수를 점검한 데이터를 준비하고 요약 기능을 기사 분석 흐름에 연결하며 팀의 결과물을 완성하는 데 기여했습니다. 네 명의 협업을 통해 뉴스 분류와 요약 기능을 함께 갖춘 결과물을 만들 수 있었습니다. 이 경험에서 개인의 담당 기능을 끝내는 것만큼 다른 작업과 연결해 하나의 결과로 완성하는 과정이 중요하다는 점을 배웠습니다. 프로젝트 역할과 결과 보기 →
강연 봉사 · 다양한 관점으로 전달 방식을 다듬다
대학 연합동아리에서 중·고등학생 대상 컴퓨터공학 전공·진로 강연을 준비했습니다. 같은 전공뿐 아니라 다양한 분야의 부원들과 학생들의 반응과 강연 구성을 함께 검토했습니다. 전공이 같은지보다 학생들이 이해하고 참여할 수 있는지를 기준으로 의견을 모았습니다. 진로 안내에 Python 게임 시연을 더하고, 발표 연습을 통해 어려운 표현과 설명 순서를 다듬었습니다. 이후 학생들의 질문이 게임의 작동 원리와 구현 방법으로 구체화됐습니다. 다른 배경을 가진 사람들의 관점을 반영하며 기술을 쉽게 설명하는 방법을 배웠습니다.
2인 팀 프로젝트
보이스피싱 · 해결할 문제의 기준을 맞추다
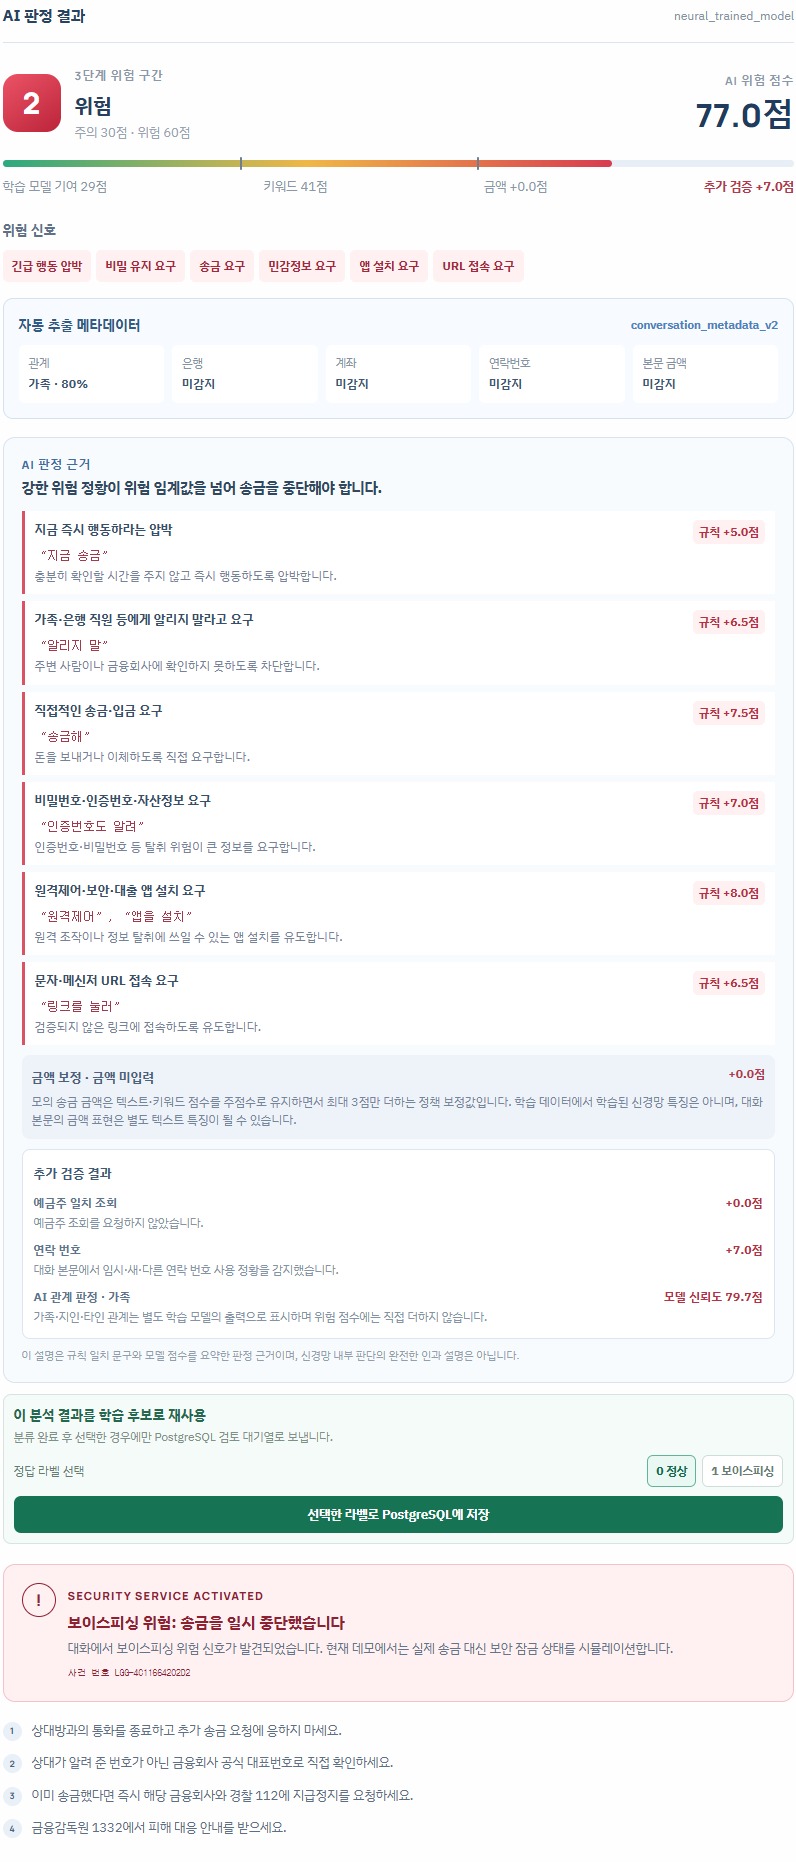
금융 현안 AI 프로젝트의 주제를 정할 때, 저는 보이스피싱 탐지 금융 비서를 제안했고 팀원은 고령자·금융 소외계층을 위한 상품 안내와 가입 절차 지원을 제안했습니다. 금융사기 피해 증가와 수법 고도화를 근거로 탐지가 필요한 이유를 설명하고 팀원을 설득했습니다. 최종적으로 보이스피싱 탐지 방향에 합의해 프로젝트를 진행했습니다. 의견이 다를 때는 해결하려는 문제와 필요성을 구체적으로 설명해야 한다는 점을 배웠습니다. 프로젝트 역할과 결과 보기 →
3인 팀 프로젝트
디지털 트윈 · 목표는 지키고 방법은 바꾸다
촬영 장비와 모델 용량의 제약으로 웹 시연이 어려워지자 주제 변경과 기존 방식 유지로 팀의 의견이 나뉘었습니다. 저는 작품 배치·공간 탐색이라는 공동 목표를 다시 정리하고, 팀원들과 품질·용량·웹 호환성을 기준으로 대안을 비교했습니다. Mesh 변환·GLB 분할에 합의한 뒤 맡은 배치 알고리즘과 DB·웹 연동을 수정해 핵심 기능을 기한 내 시연했습니다. 서로의 작업이 연결되는 지점까지 확인하며 함께 결과를 완성했습니다. 프로젝트 역할과 결과 보기 →